
この記事では、Google による論文 Hidden Technical Debt in Machine Learning Systems (Sculley et al. 2015) を手がかりに、機械学習プロダクトにおける技術的負債の性質と、実務で意識したい観点を整理します。
※ 2015 年発表の論文ですが、指摘されている原理・構造的課題は現在の MLOps においても引き続き有効な視点として参照されています。
なぜ今この論文を取り上げるのか
筆者の所属する組織では、転職希望者と求人のマッチング精度向上を目的に、複数のプロダクトで機械学習モデルの開発・運用を行っています。機械学習活用の規模が拡大するにつれ、「精度は出ているが運用コストが膨らんでいる」「似たモデルが別々に開発されている」「特徴量やパイプラインの依存関係が見通しにくい」といった課題に、チームとして実感を持って直面するようになりました。
これらの課題を振り返ったとき、Sculley らの論文が指摘する構造的問題と、我々が経験してきた問題との重なりが非常に大きいことに気づきました。2015 年の論文でありながら、10 年経った今もなお、機械学習プロダクトを運用する組織にとって「あるある」と感じる指摘ばかりです。
そこで、この論文の内容を組織内の共通言語として整理し、チーム内で共有しました。また、こうした共通言語を持つことの価値は、社内だけに閉じるものではないと考え、今回外部発信として再構成することにしました。
技術的負債
「技術的負債」とは、開発スピードを優先した設計や、将来の保守を後回しにした実装によって生じる、後々の修正コストのことです。短期的には合理的な判断であっても、負債である以上、いずれ返済が必要になります。
機械学習の文脈では、精度改善や素早い検証が重視される一方で、運用や保守の複雑さが見えにくくなりがちです。そのため、通常のソフトウェア以上に、気づかないうちに負債が蓄積しやすい領域だといえます。
機械学習プロダクトにおける技術的負債の性質
標準的なソフトウェアエンジニアリングにおける技術的負債の解消は、新機能の追加ではなく、ユニットテストの整備、可読性の改善、ドキュメント追加、未使用コードの削除といった、将来の変更を容易にするための地道な作業を指します。
一方で、Sculley らの論文は、機械学習システムにおける技術的負債はさらに深刻だと指摘します。理由は、負債がコードだけでなく、データ、特徴量、パイプライン、設定、運用、そしてチーム文化にまで広がるためです。
コードではなく「データとシステム全体」に負債が溜まる
一般的なソフトウェアでは、負債はコード構造や設計の悪さとして比較的観測しやすい形で現れます。しかし機械学習では、どのデータソースに依存しているか、上流の変更がどこに波及するか、といった問題がシステムの外縁部に潜みます。
- どの入力データ(特徴量やログなど)に依存しているかが一覧化されていない
- 上流データの仕様変更で精度が急落しても原因特定に時間がかかる
この種の問題は、コードレビューだけでは発見しにくく、見えない負債として蓄積します。
「何かを変えると全部変わる」CACE 原則
論文では CACE (Changing Anything Changes Everything) という原則が紹介されています。特徴量を 1 つ追加する、学習データ期間を変える、ハイパーパラメータを調整する、といった小さな変更が、モデル全体の振る舞いを広く変えてしまうという考え方です。
CACE 原則は特徴量だけでなく、ハイパーパラメータ、学習設定、サンプリング方法、収束閾値、データ選択など、広い範囲に当てはまります。通常のソフトウェアで期待される「局所的な変更」が成立しにくい点は、機械学習特有の負債源です。
データ依存関係が複雑で、しかも見えない
コードの依存関係はツールで追跡しやすい一方、データ依存関係は可視化されにくいのが現実です。特に他チームが管理するスコアや集計値、外部データなどを特徴量として利用すると、依存先の変更が静かにモデル品質へ影響します。
- 便利だからと取り込んだ他チームの出力データが、変更通知なしに仕様変更されて壊れる
- ログ定義や前処理変更が、後から精度悪化として表面化する
依存関係が増えること自体が、将来の変更容易性を下げる負債になります。
Correction Cascades
論文では Correction Cascades(補正の連鎖) という問題も指摘されています。これは、あるモデルの出力を入力として、その上にさらに別の補正用モデルを構築していく構造のことです。根本のモデルを直すのではなく、「ずれた分を上から補正する」モデルを積み重ねていく形です。
短期的には効率的に見えますが、元のモデルを改善しようとすると、その上に乗っている補正モデルすべてに影響が波及します。結果として「どのモデルも単独では安全に変更できない」状態に陥り、改善の自由度が大きく下がります。
モデルが世界を変え、その世界がまたモデルを変える
機械学習モデルは予測するだけでなく、ランキング、レコメンド、スコアリングなどを通じてプロダクトの挙動そのものを変えます。その結果、モデルの出力がユーザー行動を変え、その行動ログが次の学習データになる、というフィードバックループが生まれます。
さらに、異なるシステム同士が間接的に影響し合う「Hidden Feedback Loops(隠れたフィードバックループ)」は、オフライン評価では見抜きにくく、実運用後にじわじわ問題化しやすい点が厄介です。
「ちょっとだけ精度を上げる」ための特徴量が負債を増やす
論文では、過小利用される特徴量やデータ依存の典型として、以下の 4 パターンが挙げられています。
- Legacy Features(役目を終えた古い特徴量):新しい特徴量の追加により冗長になったが、それが検知されずに残り続けているもの
- Bundled Features(まとめて追加された特徴量群):グループ単位で評価・追加された結果、個々の寄与が検証されないまま残っているもの
- ε-Features(ごくわずかな改善しかもたらさない特徴量):精度向上が微小にもかかわらず、複雑さやコストだけを増やしているもの
- Correlated Features(他の特徴量と強く相関する特徴量):因果関係ではなく相関に依存しているため、環境変化に対して脆弱になりやすいもの
これらに共通するのは、「精度にはほとんど貢献しないのに、システムの複雑さと壊れやすさだけを増やしている」という構造です。
例えば、複雑な前処理や埋め込み計算を必要とする高コスト特徴量が、全体性能への寄与が小さいまま残り続けると、以下のような負債になります。
- 推論時間やインフラコストの増加
- 上流パイプラインやモデル更新に伴う運用リスクの増加
- 効果が小さいのに誰も削除できない状態の固定化
一般的に推奨される実践として、leave-one-feature-out 評価(「各特徴量が予測にどれだけ貢献しているか」を厳密に測定するための評価手法)や、特徴量ごとの寄与とコストの見直しが重要です。
機械学習コードの周辺に広がる「配管工事」のようなコード群
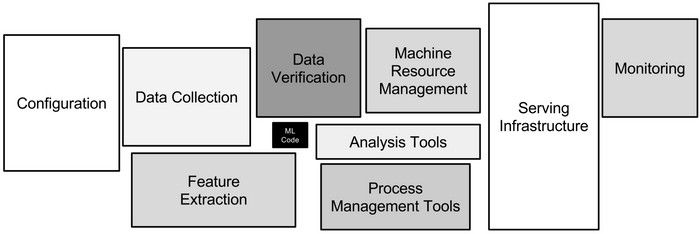
実際の機械学習プロダクトでは、学習アルゴリズムそのものよりも、データ収集、前処理、特徴量生成、監視、評価、デプロイなどの周辺コードが圧倒的に多くなります。論文では、成熟したシステムでは機械学習コードが最大でも 5% 程度で、残りの大部分が「グルーコード」— つまり汎用パッケージやライブラリの入出力を自社のデータ形式やパイプラインに合わせるために書かれる接続用の実装 — になりうると指摘しています。
論文ではこうした周辺コードの肥大化を plumbing(配管工事)に例えています。配管が複雑に入り組むほど、新しい特徴量追加、古いロジック削除、別モデル実験のすべてが難しくなり、負債の返済コストは急速に上がります。
Config と運用が「コード以上の負債」になりうる
機械学習システムでは、利用データ、特徴量の有効化、学習条件、閾値設定など、多数の設定が存在します。成熟したシステムでは、コードより設定のほうが複雑になることも珍しくありません。
論文では、良い設定システムの原則として、差分指定のしやすさ、ミスの起きにくさ、差分の可視化、自動検証、そして設定自体をレビューとバージョン管理の対象にすることを挙げています。設定に埋め込まれた暗黙知を放置すると、それ自体が大きな負債になります。
外部世界の変化とともに「放っておけない」システムになる
一般的なソフトウェアは仕様どおりに動作しているかを確認することが中心ですが、機械学習システムでは、外部世界の変化に応じた継続監視が不可欠です。
- 予測分布と実績分布のズレ
- 過剰なアクションを抑えるための制御
- 上流データ提供元の異常や SLO の監視
「作って終わり」ではなく、「運用し続けて初めて成立する」点が、機械学習システムの負債を大きくしています。
まとめ
機械学習プロダクトの技術的負債は、コードだけでなく、データ依存、特徴量、パイプライン、設定、運用、そして開発文化にまたがって発生します。そのため、「精度が出ているから問題ない」という見方だけでは不十分です。
モデル開発に関わるメンバー自身が、「この特徴量や依存関係は、将来どんな運用負債になりうるか」を意識することが、長期的な保守性を大きく左右します。
実務で起こりやすい技術的負債の例
ここでは、論文の内容をもとに一般的な機械学習活用組織で起こりうるパターンとして、複数チームで機械学習を活用する環境で起こりやすい問題を整理します。
類似モデルの乱立
機械学習活用が広がると、似た目的のモデルがチームごとに個別開発され、再利用や共有が進まないことがあります。その結果、仕様が少しずつ異なる類似モデルが増え、どれを基準に保守すべきかが分かりにくくなります。
これは、プロセス管理負債や文化的負債と密接に関係します。短期的には各チームにとって合理的でも、長期的には改善の重複や監視運用コストの増大として返ってきます。
レビューされない分析コードが本番化する
分析用に書かれた SQL やスクリプトが、そのまま本番ロジックに近い扱いになることは珍しくありません。この状態では、ロジックの品質、例外処理、保守性、再現性が十分に担保されないまま、重要な処理が運用されるリスクがあります。
また、論文でいう Undeclared Consumers(想定していなかった下流システムが勝手に出力を利用し始める問題) のように、想定外の下流利用が生まれると、変更しづらい隠れた結合が発生します。結果として、「危険だが誰も安全に直せないコード」が残りやすくなります。
費用対効果の低い高コスト特徴量
高コストな特徴量は、追加当初は有効でも、時間が経つと寄与が薄れたまま運用負荷だけが残ることがあります。小さな精度改善のために、複雑な依存や重い前処理を長期維持するのは、典型的な負債です。
この種の特徴量は、定期的な棚卸しと削除判断が重要です。削除は後ろ向きな作業ではなく、複雑性を減らす前向きな保守活動として扱うべきです。
実務で意識したい観点
論文では、精度向上だけを評価する文化が、長期的な運用コストを押し上げる「文化的負債(cultural debt)」を生むと警告しています。複雑性の削減、特徴量の削除、再現性の向上、監視の改善も、精度改善と同じくらい価値ある取り組みとして扱う必要があります。
- 再利用を優先する
似た目的のモデルや特徴量定義がすでにないかを確認する - 実験コードを本番候補として扱う
分析段階のコードでも、将来運用される可能性を前提に設計する - 精度と運用コストをセットで評価する
改善幅だけでなく、依存、保守、計算コストも意思決定に含める - 依存関係の増加を負債として認識する
便利さだけでなく、壊れたときの対応責任まで含めて設計する
「このモデル設計・特徴量・クエリは、2 年後や 3 年後にも理解しやすく、安全に変更できるか」という視点を持つことが、技術的負債の増加を抑えるうえで重要です。
我々の組織が取り組んでいること
ここまで整理してきた技術的負債の構造は、筆者の所属組織でも実感している課題そのものです。我々はこれらの問題に対して、以下のような方針で取り組みを進めています。
汎用モデル基盤の構築と機能統合
「類似モデルの乱立」への対策として、プロダクト横断で利用できる汎用的なモデル基盤の構築を進めています。個別プロダクトごとに似たモデルを開発・保守するのではなく、共通のコア機能を一つの基盤に集約し、各プロダクトがそれを利用する形に移行することで、エンハンスの投資を集中し、改善が全体に波及する構造を目指しています。
アナリストとエンジニアの協働による負債抑制
技術的負債は「モデルを作る人」と「システムを作る人」の間の分断から生まれやすい問題です。我々の組織では、アナリストとエンジニアが協力し、設計段階から運用コストや拡張性を考慮した開発を行う体制を強化しています。
ペアプログラミングやコードレビュー、社内勉強会を通じて、ドメイン知識やコーディングスキル等の共有が活発に行われること、そして「ビジネス要件を満たすだけでなく、開発コストを下げる設計を職種横断で考える」という意識の醸成に取り組んでいます。
選択と集中 — ROI に基づく投資判断
限られたリソースの中で最大の成果を出すためには、「何をやるか」以上に「何をやらないか」を意思決定することが重要です。リターンの小さい施策や、費用対効果の低い特徴量・パイプラインは、統合・廃止を前向きな判断として実行しています。
論文が警告する「文化的負債」— 精度向上だけを評価する文化 — を避けるために、精度改善と運用コスト削減の両方を等しく成果として評価する仕組みを意識しています。複雑性の削減も、新機能の追加と同じくらい価値ある仕事として扱うことが、負債を溜めない文化の基盤になると考えています。
おわりに
技術的負債は、気づいたときにはすでに大きく積み上がっていることが多い問題です。だからこそ、Sculley らの論文が提示するフレームワークを共通言語として持ち、日常の設計判断のなかで「これは将来の負債にならないか」と立ち止まれることに価値があると考えています。
我々の取り組みはまだ道半ばですが、汎用基盤の構築、職種横断の協働、そして選択と集中を軸に、「作るだけでなく、長く安全に運用し続けられる機械学習プロダクト」を目指して前進しています。同じような課題に向き合っている方々にとって、この記事が何かのヒントになれば幸いです。
参考
- D. Sculley, G. Holt, D. Golovin, E. Davydov, T. Phillips, D. Ebner, V. Chaudhary, M. Young, J-F. Crespo, D. Dennison. Hidden Technical Debt in Machine Learning Systems. Advances in Neural Information Processing Systems 28, 2015.(2026年8月12日 アクセス)
川人 晋伍 Kawahito Shingo
カスタマープロダクト本部 プロダクト開発統括部 プロダクトサイエンス部
2024 年 11 月にパーソルキャリアにデータアナリストとして入社。現在は、転職希望者と求人のマッチング精度向上に関わるデータ分析・モデル評価を担当。
※2026年8月現在の情報です。
